Kann eine KI Feedback auf dem Niveau einer geschulten Lehrperson geben? Mit einem gut gestalteten Versuchsaufbau kommt ein Forscherteam der Universität Padua jedenfalls zum Schluss, dass Feedback unabhängig von seiner Quelle lernförderlich sein kann und dass die Qualität von KI-generiertem Feedback dem einer geschulten Lehrperson nahe kommt. Was lässt sich also aus dem Artikel ableiten? Mir fallen drei Punkte auf.
Didaktik zuerst!
Erstens bleiben das didaktische Setting und die didaktischen Kompetenzen der zeitgeisttauglich formulierte Nordstern. Die Autor*innen betonen mehrfach und deutlich, dass weniger das spezifische KI-Modell entscheidend ist, sondern vielmehr wie die KI aufgesetzt wurde. Rubriken wurden festgelegt, Qualitätskriterien für Feedback wurden formuliert. “Assessment literacy” wurde dadurch hergestellt, dass der KI vorab Kriterien eingespeist wurden, an denen sie sich orientieren konnte, damit die Qualität so hoch wie möglich bleibt. Das ist in jedem Fall unverzichtbarer Bestandteil jeder Arbeit mit KI und ein Schritt, den ich in vielen ähnlich gestalteten Forschungen vermisse.
Ebenso unverzichtbar ist es für Dozierende, sich Assessment Literacy und Feedback-Kompetenz anzueignen. Das ist ein langer und mühsamer Prozess, wie Lernen generell. Meine erste Erkenntnis lautet deswegen: KI ist und bleibt ein Tool, dessen Einsatz davon profitiert, dass wir Kompetenzen im Umgang mit diesem Tool haben und gleichzeitig auch kompetente Lehrpersonen sind. Das galt bislang ebenso für alle anderen technischen Hilfsmittel, die wir in der Lehre einsetzen, wie Flipchart, PowerPoint oder auch Gruppenarbeitstechniken.
Forschung hochskalieren!
Zweitens brauchen wir einen Forschungsmodus, der sich zwei Stärken der KI zu eigen macht: Schnelligkeit und Skalierbarkeit. Der Artikel arbeitet mit o4-mini, einem Modell, das noch vor Erscheinen der Studie aus ChatGPT entfernt wurde. Auch das chinesische Modell Deepseek R1 wurde längst durch neuere Modellgenerationen überholt. Die Autor*innen sprechen von „contemporary AI-generated feedback“, doch contemporary war es zum Zeitpunkt der Veröffentlichung schon nicht mehr. Wir brauchen ein wissenschaftliches Forschungs- und Veröffentlichungssystem, das schneller fundierte Ergebnisse liefert als der Entwicklungszyklus der Sprachmodelle.
Belanglos ist die Modellwahl trotz Didaktik nicht. ChatGPT-o4-mini lieferte insgesamt bessere Ergebnisse als Deepseek R1. Erinnern Sie sich, als Anfang 2023 bei einem Experiment des Bayerischen Rundfunks GPT-3.5 am bayerischen Abitur scheiterte und GPT-4 es wenige Monate später mit «gut» bestand? Seither hat jede Modellgeneration nachgelegt. o4-mini war bereits ein Reasoning-Modell: Es „denkt“ mehrschrittig. Kombiniert mit vorab eingespeisten Kriterien lässt sich der Output gezielt verbessern. Genau das haben die Forschenden genutzt. Wie ein aktuelles Modell heute abschneiden würde, ist offen. Genau das ist Teil des Problems.
Alle paar Monate kommen neue Funktionen dazu: CustomGPTs, Verarbeitung und Generierung diverser Dateiformate, Projekte, Skills, Konnektoren, Desktop-Applikationen, Fernsteuerung per Smartphone, Vibe Coding. Es fühlt sich an, als würden wir durch eine Woche Urlaub bereits abgehängt. Mittlerweile können wir agentische Funktionen relativ einfach nutzen und uns lokale Modelle installieren, die ohne Internetzugang funktionieren. Wer heutzutage nur chattet, lässt viel Potenzial liegen. Aber selbst tagesaktuell veröffentlicht bliebe die Studie anekdotisch: eine kleine Stichprobe, ein sehr spezifischer Testgegenstand. Lässt sich ein Modus finden, der wissenschaftliche Forschung schnell und skalierbar macht?
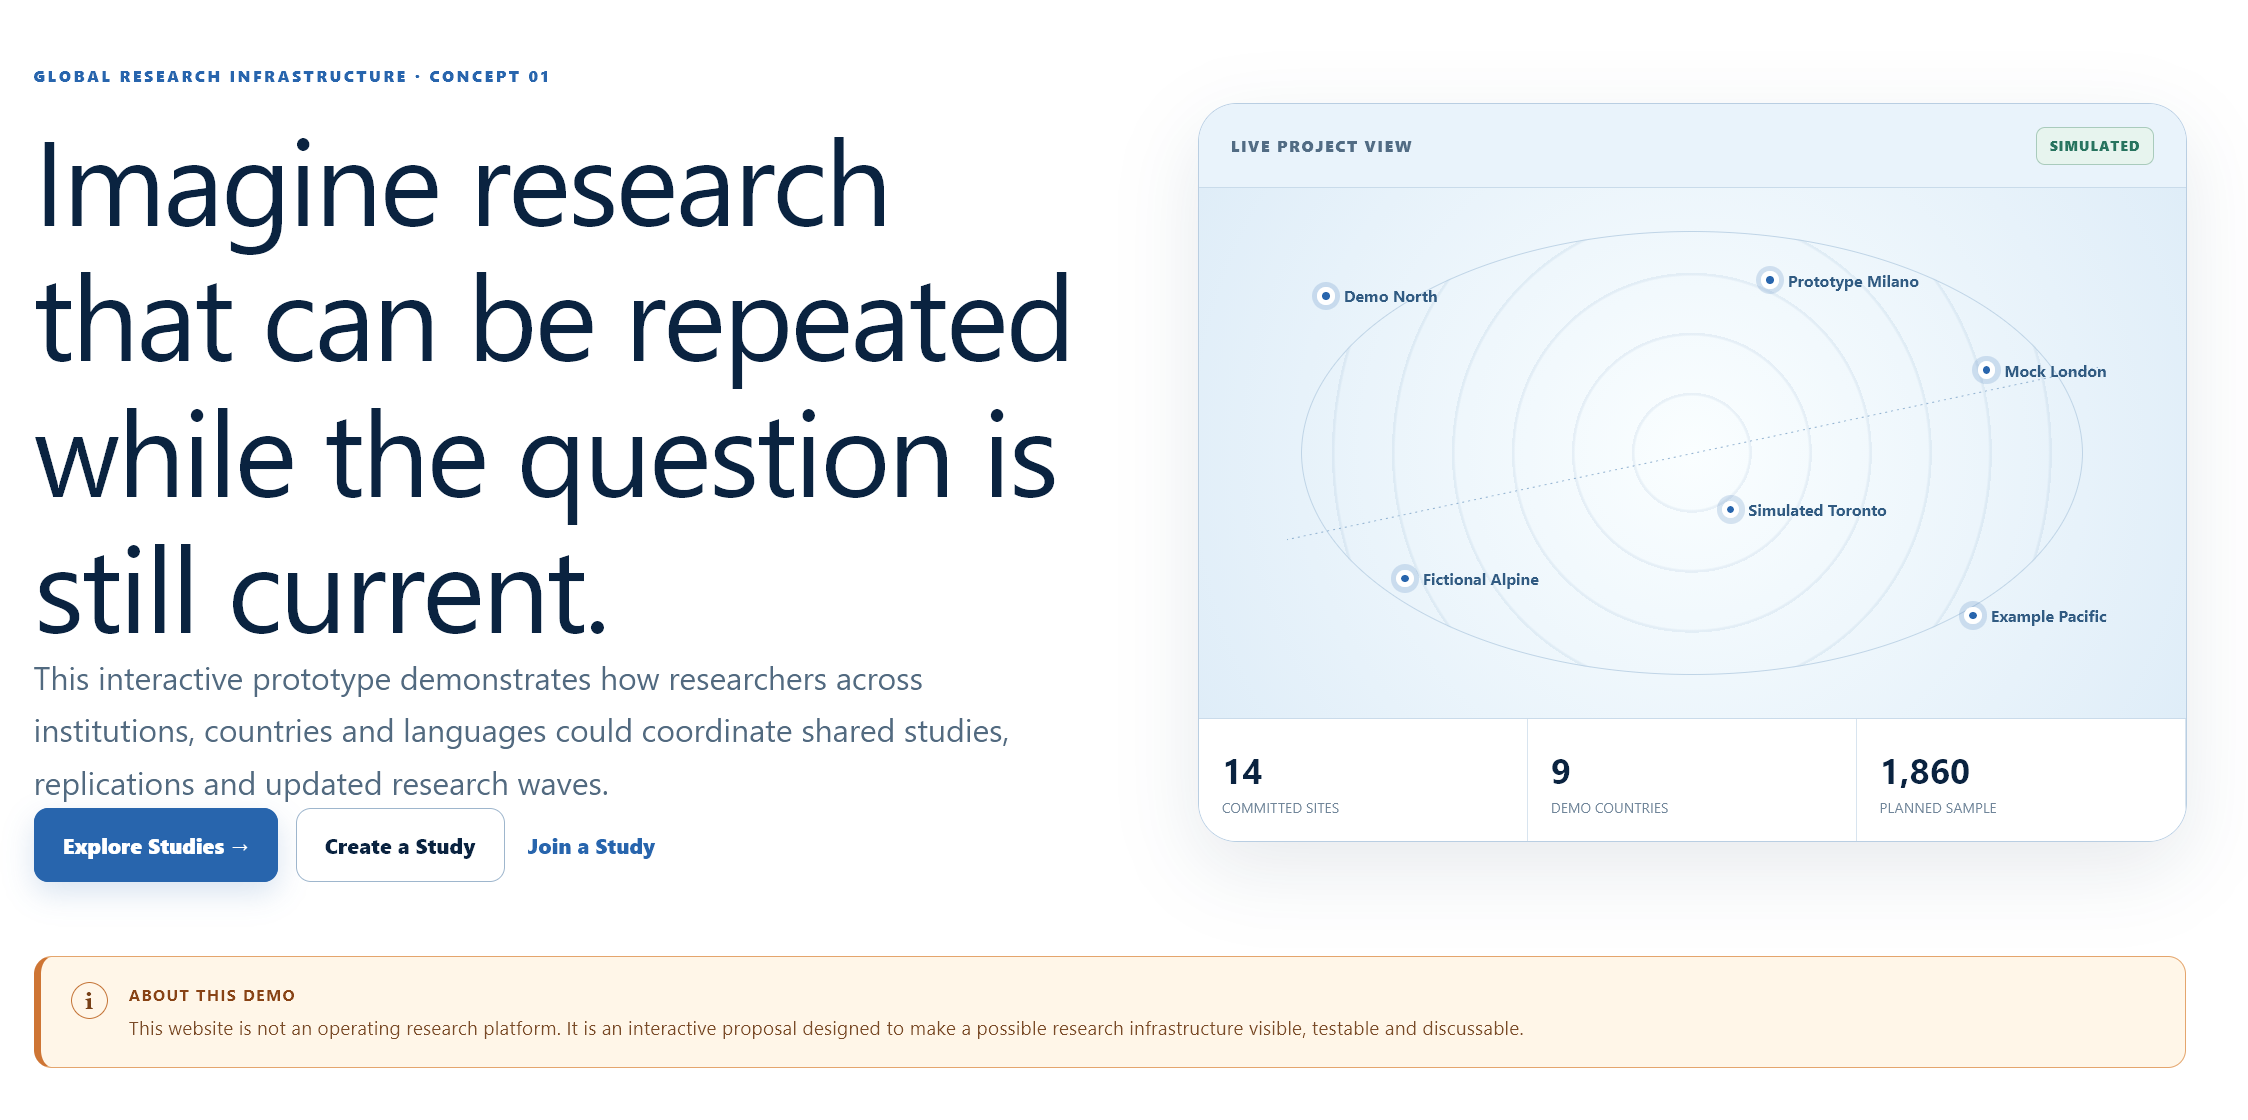
Vielleicht so: eine Plattform, halb Vorregistrierung, halb Jobbörse. Ein Versuchsaufbau wird publiziert, Forschende weltweit klinken sich ein, führen ihn im eigenen Umfeld durch und tragen ihre Daten gemäss einer gemeinsamen Rubrik in dieselbe Datenbank ein. Wer will dieses Projekt angehen? Oder soll ich schnell einen Prototyp mit ChatGPT bauen? Gern geschehen
Schnelligkeit und Skalierbarkeit erfahren aber ein weiteres Nadelöhr: Den langwierigen Prozess der Veröffentlichung. Zwischen abgeschlossener Forschung und veröffentlichtem Artikel kann viel Zeit vergehen. So viel offenbar, dass das verwendete KI-Modell bereits veraltet ist. Auch hier könnte KI helfen, denn wissenschaftliche Ergebnisse brauchen keine literarischen Texte, sondern Darstellungen, die präzise, nachvollziehbar und schnell rezipierbar sind. Entsprechend aufgesetzt kann KI auch hier massgeblich unterstützen. Menschliche Kontrolle bleibt Pflicht, aber kontrollieren geht schneller als selbst produzieren. Entscheidend ist, dass wissenschaftliche Standards eingehalten werden und relevante Ergebnisse noch relevant sind, wenn sie erscheinen.
KI nutzen!
Drittens, ich mach es kurz: Wenn KI-Feedback unter gut gestalteten Bedingungen vergleichbar wirksam ist wie das einer erfahrenen Lehrperson, dann lasst uns das nutzen! Ich möchte hier niemandem auf die Füsse treten, jedenfalls nicht zu fest, mir selbst dafür gleichzeitig auch ein bisschen: Wer hat denn schon eine konsistent hohe Feedback-Kompetenz? Unter allen Dozierenden wird es nicht nur tagesformabhängige Schwankungen geben. Feedback zu geben ist eine komplexe Kompetenz, die Zeit und Energie erfordert. Beides ist limitiert. Feedback ist nicht dadurch gut, dass es von einem Menschen kommt. Feedback ist gut, wenn es die uns bekannten Kriterien für gutes Feedback erfüllt. Menschsein ist dafür weder notwendig noch hinreichend.
KI-Feedback muss auch nicht dasselbe sein wie menschliches Feedback. Das geht gar nicht, also sollten wir auch nicht so tun und dann das vorhersagbare Scheitern verurteilen. Menschliches Feedback hat Qualitäten, die lernförderlich sind und die ich nicht missen möchte. Der persönliche Kontakt, Mitgefühl über Formulierungen hinaus, die konkrete reale Situation, in der Feedback stattfindet.
Wenn ich aber auf falsche Antworten bei einem Multiple Choice-Test automatisierte Tipps erhalte, dann ist das auch lernförderlich, ganz ohne KI und ganz ohne Menschen, wenn es einmal aufgesetzt ist. Niemand würde je behaupten, es könnte menschliches Feedback ersetzen. Wir lassen uns blenden von der beeindruckenden Illusion KI-generierter Texte, von dem Imitieren menschlicher Kommunikation durch Rechenoperationen. Es muss nicht dasselbe sein. Wir sind in der Lage, als solches gekennzeichnetes KI-Feedback entsprechend einzuordnen und produktiv zu nutzen. Und dabei steigern wir gleichzeitig unsere KI-Kompetenz, genauer: unsere KI-generierten-Text-Erkennungs-und-Einordnungs-Kompetenz. Ausserdem gilt für jedes Feedback unabhängig von seiner Quelle, dass die rezipierende Person in der Lage sein muss, das Feedback zur eigenen Kompetenzsteigerung einzusetzen.
KI-generiertes Feedback hat Qualitäten, allen voran Schnelligkeit und Skalierbarkeit. Beides sind hochrelevante Kriterien für gutes Feedback in unseren modernen Lernsituationen, aber allein durch Menschen nicht in diesem Umfang zu leisten. Lasst uns also nicht über ein ODER diskutieren, menschliches ODER KI-generiertes Feedback, sondern über ein UND. Dort, wo menschliches Feedback möglich und sinnvoll ist, werden wir es einbringen. Und sonst hilft KI-generiertes Feedback vor allem beim selbstgesteuerten Lernen.
Feedback ist nicht dadurch gut, dass es von einem Menschen kommt. Entscheidend ist, was den langfristigen Lernerfolg unterstützt. Und was unter realen Bedingungen überhaupt geleistet werden kann. Wenn gut aufgesetzte KI Feedback auf dem Niveau erfahrener Lehrpersonen geben kann, wäre es regelrecht fahrlässig, darauf zu verzichten. Bei der Entwicklungsgeschwindigkeit von KI müssen wir ausserdem beachten, dass die Systeme immer besser werden. Gleichzeitig müssen wir immer besser darin werden, sie einzusetzen, und Lernende darin, Feedback produktiv zu nutzen. Also ran an die Kompetenzen!